Git dla Embedded
🖥️ Kurs Git dla Embedded
Dla programistów embedded, którzy chcą pracować z gitem tak, jak pracują zespoły programistyczne — i przestać kopiować katalogi.
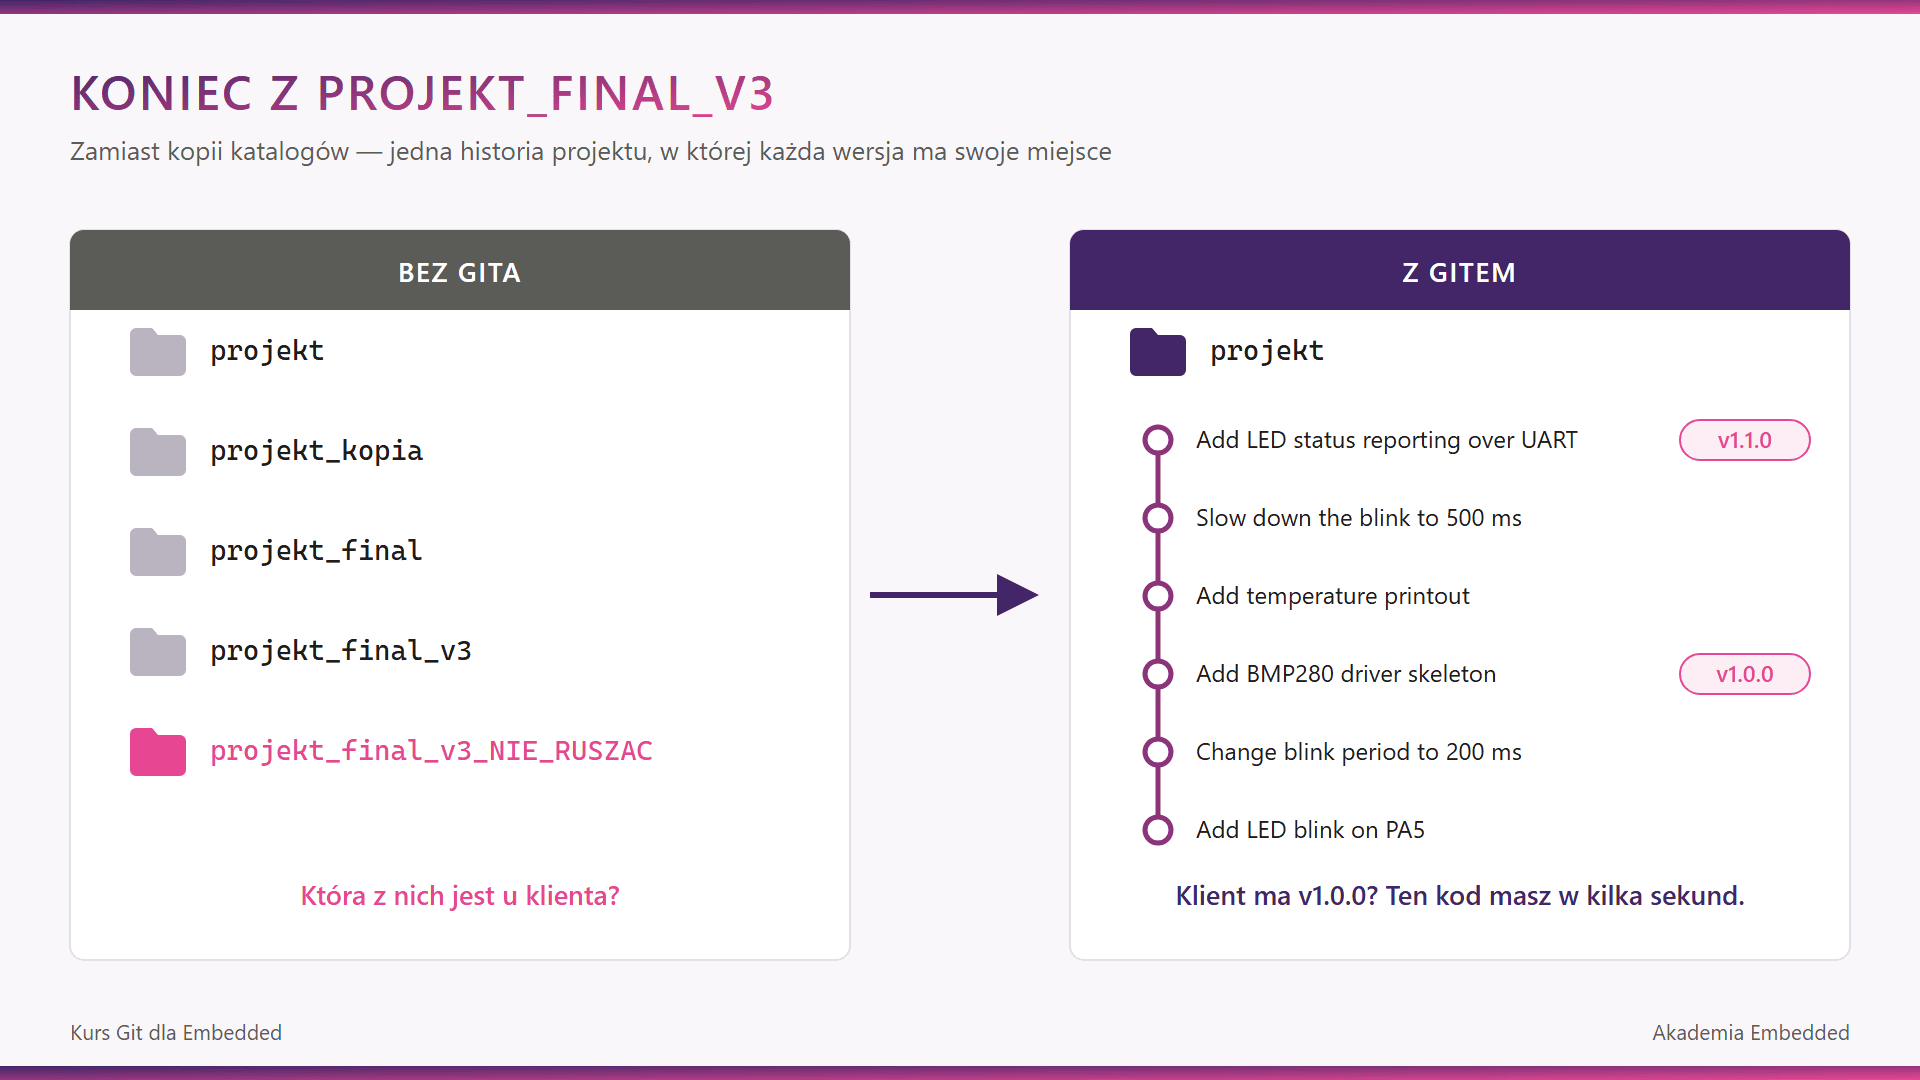
„Wczoraj działało, dziś nie działa.” Na dysku katalogi projekt, projekt_kopia, projekt_final_v3. A klient pyta o urządzenie sprzed pół roku i nikt nie wie, który z tych katalogów ma wgrany.
Ten kurs uczy pracy z gitem tak, jak pracują zespoły programistyczne: z czytelną historią, powrotem do każdego release’u i zmianami, które przechodzą code review, zanim trafią do kodu produkcyjnego. 14 lekcji wideo, 4 godziny 10 minut, dostęp dożywotni. Płytka nie jest potrzebna — wystarczy dowolny Twój projekt.
14 lekcji
wideo, krok po kroku
4 h 10 min
konkretnie, bez dygresji
dostęp dożywotni
od razu po zakupie
🎬 Zobacz, o co chodzi w kursie
Kilka minut o tym, jak wygląda porządna praca z gitem w projekcie embedded — i co dokładnie jest w kursie.
😩 Znasz gita. Mniej więcej.
Większość z nas łapie gita z doskoku. Kilka komend na pamięć, reszta „jakoś to będzie”. I przez długi czas to działa. Aż do dnia, w którym:
❌ wczoraj działało, dziś nie działa — i nie masz pojęcia, co zmieniłeś,
❌ na dysku masz projekt, projekt_kopia, projekt_final i projekt_final_v3_NIE_RUSZAC,
❌ klient dzwoni w sprawie urządzenia sprzed pół roku, a Ty nie wiesz, która wersja jest u niego wgrana,
❌ asystent AI poprawił kilkanaście miejsc w trzech plikach i nie wiesz, które z nich chcesz zostawić,
❌ git wypisuje coś na czerwono, więc kopiujesz katalog i zaczynasz od nowa,
❌ zaczynasz pierwszą pracę, a zespół zakłada, że gita już znasz — nikt Cię go na wejściu nie będzie uczył.
👉 Problem nie siedzi w komendach. Komendę znajdziesz w pięć sekund.
👉 Siedzi w sposobie pracy — i tego żaden tutorial z pojedynczą komendą Cię nie nauczy.
🔧 Git w embedded — w czym jest inny
Git jest ten sam. Projekt — nie do końca. Uczciwie: większość pracy z gitem wygląda tak samo w każdej branży. Ale projekt embedded ma kilka rzeczy, o które inni się nie potykają:
🔹 Ponad dwieście plików w świeżym projekcie z CubeMX. Część to Twój kod, część wygenerował CubeMX, część to biblioteki producenta, a część to śmieci po kompilacji, które zmieniają się przy każdym buildzie. Co z tego ma trafić do repozytorium?
🔹 Generator kodu. Przegenerujesz projekt, a CubeMX nadpisze Ci pliki. Bez gita nie wrócisz do tego, co było.
🔹 Firmware żyje na urządzeniach. W webie wdrażasz nową wersję i po sprawie. U nas stara wersja siedzi u klienta w szafie latami — i musisz umieć do niej wrócić, dokładnie do niej.
🔹 Kod pod NDA. Nie każde repozytorium może trafić na cudzy serwer.
Część z tych rzeczy da się wywnioskować samemu. W kursie widzisz je jednak na prawdziwym projekcie wygenerowanym w CubeMX — z przykładami, dzięki którym od razu widać, czego do repozytorium nie wrzucamy i dlaczego.
Jedna rzecz, żeby było jasne od początku: gita ćwiczymy na projekcie STM32, bo na prawdziwym projekcie widać, jak git się zachowuje. Ale to kurs gita, nie programowania STM32 — zmiany w kodzie są drobne i czasem niezbyt sensowne, bo mają dać gitowi materiał do pracy.
📚 Co zyskasz, dołączając do kursu?
„Co ja zmieniłem od piątku?”
widzisz dokładnie te linie, które się zmieniły, z opisem, który po pół roku dalej coś mówi.
Klient z wersją sprzed pół roku
każdy release ma swój tag, a Ty w kilka sekund masz na dysku dokładnie ten kod, który jest u niego.
„Wczoraj działało”
cofasz się do wersji, która działała, sprawdzasz i wracasz. Zakomentowane stare funkcje w main.c możesz wreszcie skasować.
Release’y są nietykalne
rdzeń firmware’u, czyli kolejne release’y, zostaje nietknięty, a każdy nowy feature piszesz obok. Jutro prezentacja, a Ty w połowie przepisywania sterownika? Wgrywasz ostatni release i śpisz spokojnie. Nieprzetestowane nie trafia do kodu produkcyjnego.
Koniec z kodem wysyłanym mailem i ZIP-em
w zespole tak się nie pracuje, bo po tygodniu nikt nie wie, kto co komu wysłał i kto ma które pliki. Jedynym źródłem prawdy jest repozytorium, do którego wszyscy się synchronizują i z którego wszyscy korzystają.
Wiesz, co zmienił kolega
bez pytania, proszenia i przypominania. Wszystko jest na serwerze, a Ty widzisz to przy najbliższej synchronizacji.
Wszyscy grają według tych samych zasad
wiesz, jak wysyłać swoje zmiany i jak pobierać cudze, a reszta zespołu robi dokładnie to samo.
Zmiany od AI pod kontrolą
każdą widzisz czarno na białym i cofasz te, których nie chcesz.
Pięć roboczych commitów → jeden porządny
tak się pracuje naprawdę, tylko nikt tego nie pokazuje. Oryginał zostaje nietknięty obok.
Pull request i code review
kolega zostawia komentarz przy konkretnej linii, poprawiasz, zatwierdza.
Pierwszy tydzień w nowej pracy
„zrób brancha, wystaw PR-a, ktoś Ci zrobi review”. I wiesz, o co chodzi.
🗺️ Jak wygląda Twoja droga w kursie?
Trzy etapy — od pustego katalogu do release’u.
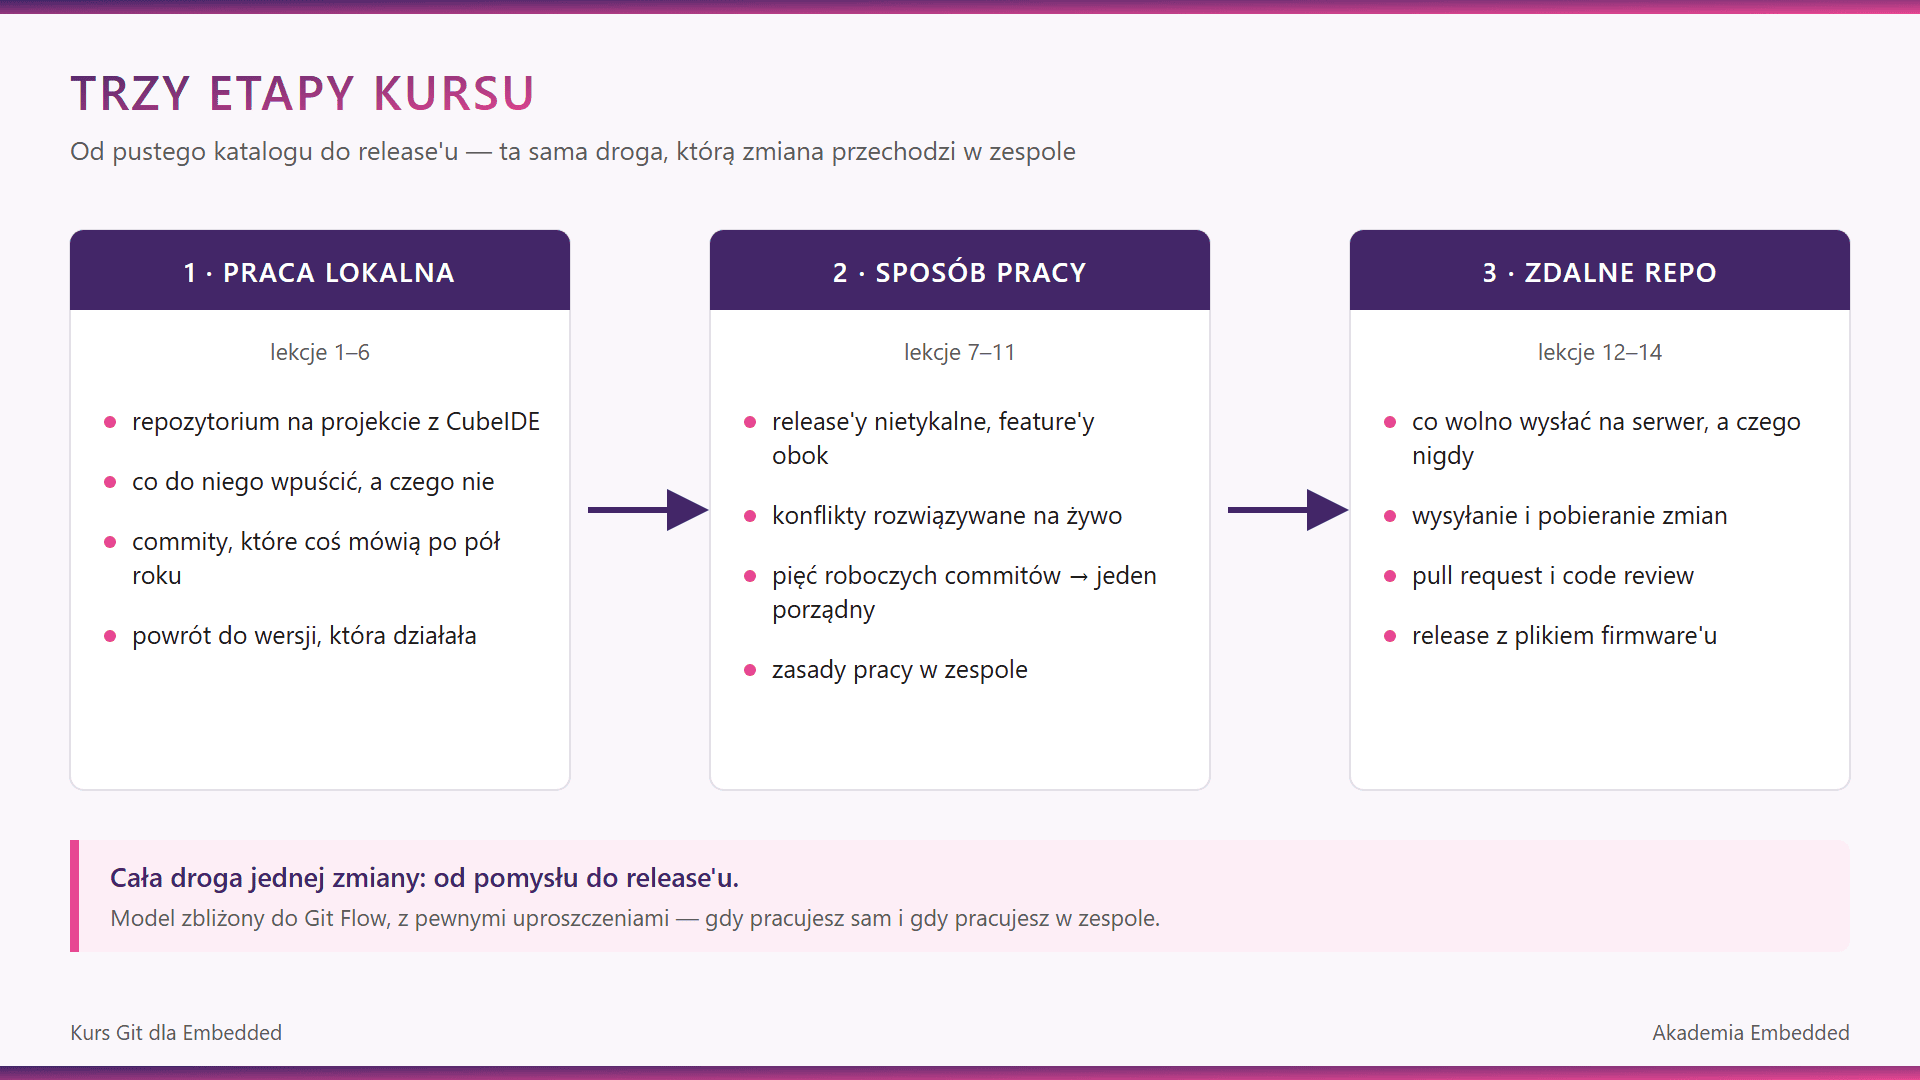
1. Praca lokalna
Instalacja i repozytorium na projekcie z CubeIDE. Przede wszystkim jednak jak się zachowywać przy wprowadzaniu zmian: jak je dokumentować, jak pisać opis commita, który coś mówi po pół roku, jak wprowadzać zmiany małymi krokami i jak nie wpuścić do repozytorium tego, co nie ma do niego trafić. Do tego cała lekcja o tym, jak wyjść z typowych wpadek — od cofnięcia niezapisanej zmiany po powrót do wersji firmware’u, która działała.
2. Sposób pracy
Model zbliżony do Git Flow, z pewnymi uproszczeniami. Branche i konflikty — skąd się biorą i jak z nich wyjść, gdy git je zgłosi. Rebase i squash, czyli jak przygotować porządną zmianę do code review: pięć roboczych commitów zamienionych w jeden, a debugowe printfy w stylu „dupa1″, „dupa2″ zostają za drzwiami — nie wchodzą do kodu. I zasady, dzięki którym w zespole branch z release’ami zawsze działa.
3. Zdalne repozytorium
Zdalne repozytorium to podstawa pracy zespołowej — i tego, jak się wobec niego zachowywać. Wstęp do GitHuba od podstaw: zakładanie repozytorium, praca z nim, wysyłanie i pobieranie zmian. Zobaczysz też, jak zdalne repozytorium wygląda u Ciebie lokalnie, w gicie. Do tego co wolno wysłać na serwer, a czego nigdy, pull request od początku do końca i release z plikiem firmware’u do pobrania.
👉 To jest cała droga jednej zmiany: od pomysłu do release’u. Dokładnie to, co będziesz robić w zespole.
🎯 To nie jest encyklopedia gita
Git ma setki komend i opcji, a większości z nich przez lata pracy nie użyjesz. Ten kurs to podstawa pracy z gitem w życiu zawodowym — wybrana na podstawie tego, czego sam używam na co dzień w projektach embedded.
To kompletna ścieżka od początku do końca — cała pętla pracy z gitem, którą potem możesz dowolnie dopasować do siebie. A jeśli trafisz do zespołu, który korzysta z gita trochę inaczej, i tak będziesz wiedział, jak się zachować: rdzeń pracy z gitem jest wszędzie ten sam, a różnice załapiesz od razu.
Tematy zaawansowane, takie jak szukanie błędu w historii, podmoduły, kilka katalogów roboczych jednego repozytorium czy automatyczne budowanie na serwerze, pojawiają się na koniec jako mapa dalszej drogi, a nie jako materiał kursu. Gdy będą Ci potrzebne, doczytasz je bez trudu, bo będziesz już rozumieć, jak git działa pod spodem.
🗂️ Agenda kursu — 14 lekcji
Rozwiń etap, żeby zobaczyć, co jest w każdej lekcji.
🔍 Sześć rzeczy, które zwykle wychodzą dopiero w pracy — i to boleśnie
01
Dlaczego biblioteki producenta zostają w repozytorium, a śmieci z kompilacji nie
02
Jak odłożyć przerwaną pracę na bok, gdy trzeba pilnie coś poprawić
03
Jak wrócić do wersji firmware’u, która działała — bez kopii katalogów
04
Konflikt przy merge’u — skąd się bierze i jak z niego wyjść, także wycofując się
05
Pięć roboczych commitów zamienionych w jeden porządny — bez ryzyka dla oryginału
06
Czego nigdy nie wysyłasz na serwer — i czego nie wysyłasz na cudzy
🖥️ Z jakiego oprogramowania korzystamy w kursie i dlaczego?
Git w terminalu
na Windowsie, tak jak w większości zespołów. Na Linuksie i macOS zrobisz dokładnie to samo — inaczej wygląda tylko instalacja i uruchamianie gita.
Narzędzia graficzne dołączone do gita
do oglądania historii i do wybierania, które zmiany trafią do commita. Są w każdej instalacji gita, nic nie dokupujesz.
Zwykły edytor tekstu
żeby widzieć, co robi git, a nie co robi IDE za Twoimi plecami. Projekt pochodzi ze STM32CubeIDE, ale samego IDE w kursie nie uruchamiamy — wszystko zadziała z każdym środowiskiem.
GitHub
darmowe konto, przyda się od lekcji 12.
👥 Dla kogo jest ten kurs — a dla kogo nie?
✅ Dla Ciebie, jeśli:
✅ wysyłasz sobie projekt mailem albo nosisz go na pendrivie,
✅ w projekcie na studiach pytacie się na Messengerze, kto ma najnowszą wersję,
✅ znasz kilka komend gita na pamięć, ale gdy coś wyskoczy na czerwono — kopiujesz katalog,
✅ niedługo zaczynasz praktyki albo pierwszą pracę i wiesz, że tam git jest czymś oczywistym,
✅ pracujesz sam i myślisz, że git to narzędzie dla zespołów — połowa kursu to praca w pojedynkę.
❌ Nie dla Ciebie, jeśli:
❌ na co dzień robisz rebase’y i pull requesty w zespole i nic Cię tu nie zaskoczy,
❌ szukasz wszystkich zaawansowanych opcji gita,
❌ chcesz nauczyć się programowania STM32 — tu STM32 jest tylko tłem.

👨🏫 Twój instruktor — Mateusz Salamon
Cześć! Nazywam się Mateusz Salamon. Od ponad 10 lat programuję mikrokontrolery, pracowałem w Intelu, gdzie pisałem BIOS na x86 w czystym C, a dziś uczę embedded — jestem autorem kursów STM32 dla Początkujących, STM32 na Rejestrach, FreeRTOS i Język C. Przez moje materiały przeszło ponad 1500 osób, a bloga msalamon.pl co miesiąc czytają tysiące programistów.
Trzonem tego kursu jest git z pracy w korporacji — w międzynarodowym zespole w Intelu. Nikt mnie go tam nie uczył na szkoleniu: wszyscy zakładali, że już umiem. To, czego się tam nauczyłem, stosuję do dziś we własnych projektach. Wdrożyłem to w mojej firmie i w wielu projektach, w których brałem udział, a które z jakiegoś powodu z gita nie korzystały.
Widzę to bardzo często: początkujący i małe firmy mają duży opór przed gitem. Zupełnie niepotrzebnie. To narzędzie mnóstwo ułatwia, upraszcza i przyspiesza — i moim zdaniem jest wręcz obowiązkowe od samego startu projektu.
Prowadzący jest Oficjalnym Partnerem ST (ST Partner Program)
🎬 Jak wygląda kurs od środka?
Bez podglądu lekcji — ale z konkretem, co dostajesz przy każdej z nich:
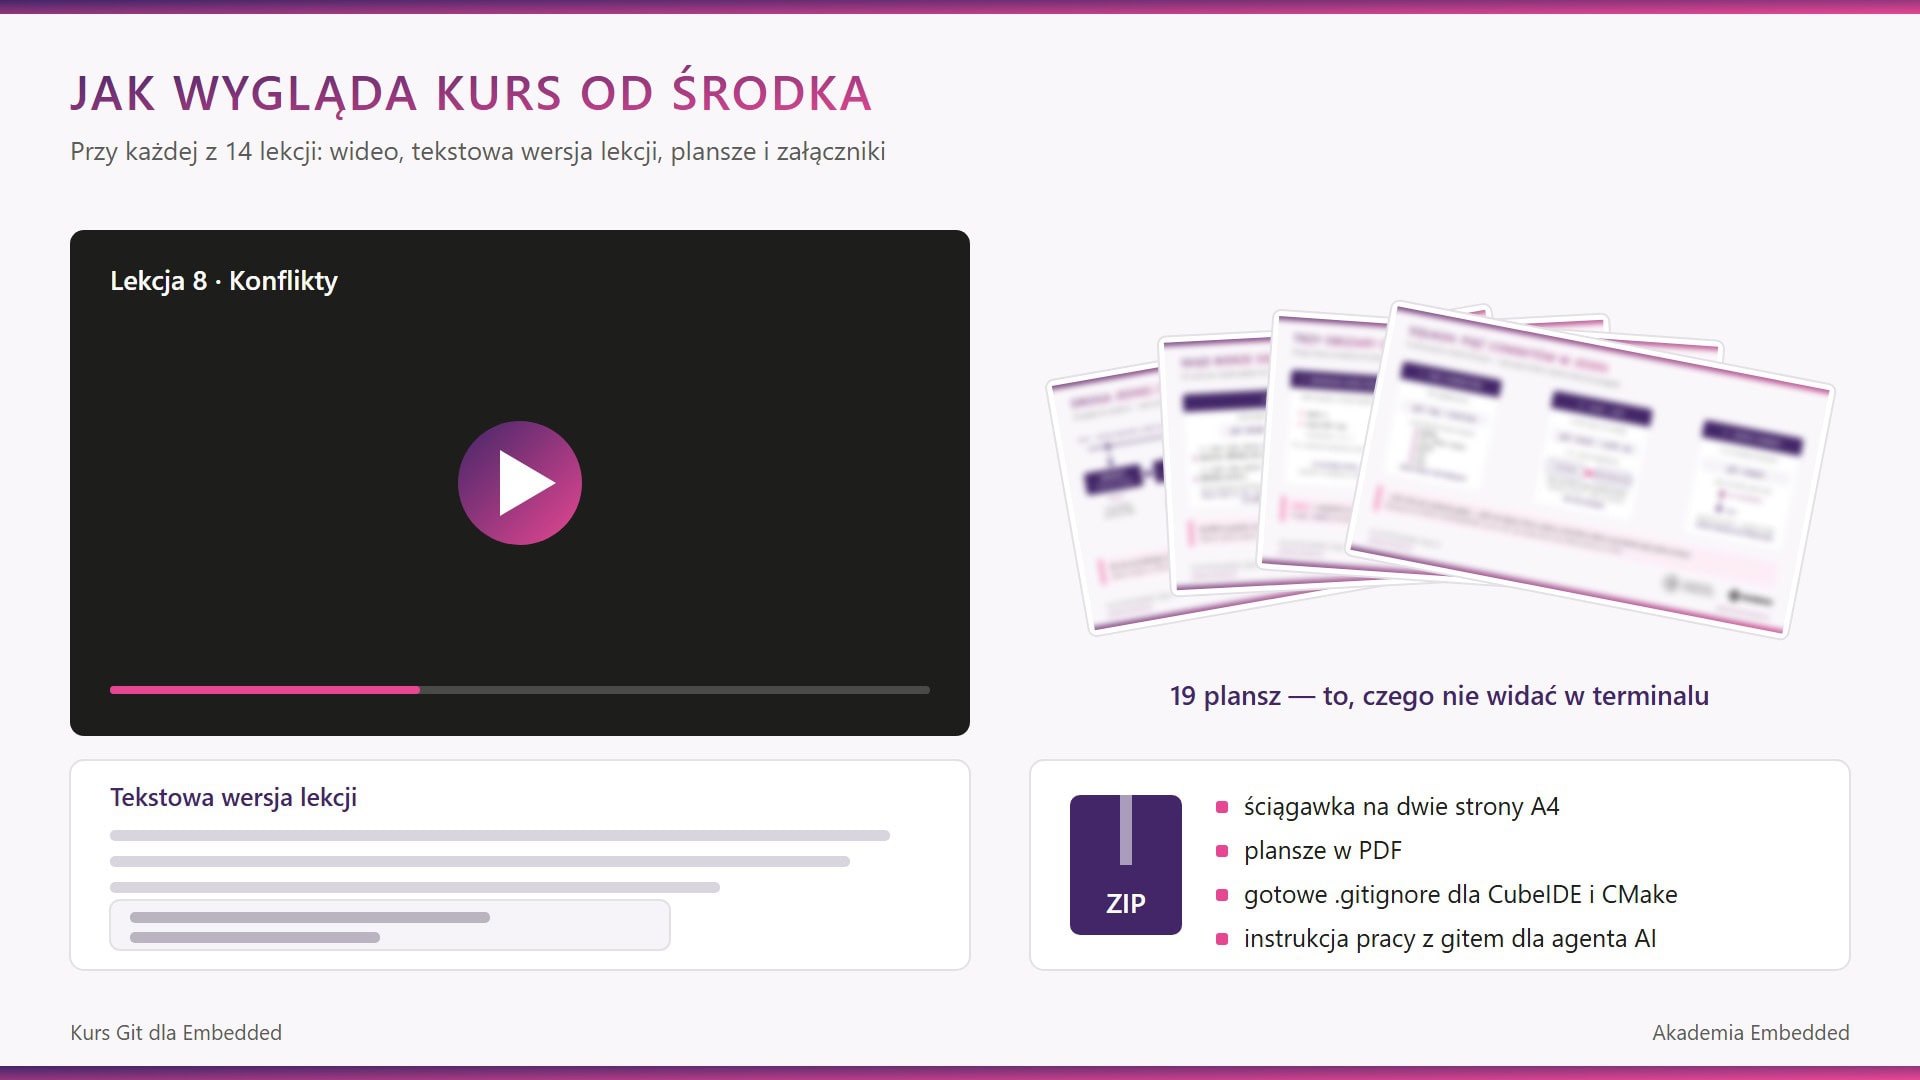
🎬 14 lekcji wideo, łącznie 4 godziny 10 minut — średnio ok. 18 minut na lekcję. Nagrane na ekranie, krok po kroku, na jednym projekcie od pierwszej do ostatniej lekcji.
📄 Tekstowa wersja pod każdą lekcją — te same kroki co na wideo, z tym, co git powinien odpowiedzieć. Nie przewijasz nagrania dziesiąty raz, żeby coś sobie przypomnieć.
🗺️ Plansze tłumaczące, co się dzieje w lekcji — 19 plansz: to, czego nie widać w terminalu, narysowane. Do obejrzenia pod lekcją i do wydruku w PDF.
⚡ Skrót na końcu każdej lekcji — wszystko, co w niej padło, zebrane w jednym miejscu. Wracasz do niego, zamiast do filmu.
📎 Załączniki do pobrania, w jednym ZIP-ie — ściągawka na dwie strony A4 ułożona według zadań, plansze w PDF, gotowe .gitignore dla CubeIDE i CMake oraz 🤖 instrukcja pracy z gitem dla agenta AI: wrzucasz ją do swojego repozytorium, a asystent kodujący trzyma się tych samych zasad co Ty.
⏳ Jak długo będziesz mieć dostęp do kursu?
Dożywotnio. Kupujesz raz i wracasz do kursu, kiedy chcesz — przed pierwszą rozmową o pracę, przed pierwszym pull requestem w nowym zespole albo wtedy, gdy git znowu wypisze coś na czerwono.
To jeden weekend nauki albo tydzień wieczorów po godzinie. A git to jedna z niewielu rzeczy w tym zawodzie, które się nie starzeją: mikrokontrolery się zmieniają, IDE się zmieniają — git, którego nauczysz się teraz, pójdzie z Tobą do każdego zespołu i każdego projektu.
📦 Co otrzymasz, kupując kurs?
✔️ 14 lekcji wideo, 4 godziny 10 minut
✔️ dostęp dożywotni, od razu po zakupie
✔️ tekstową wersję każdej lekcji, plansze i skrót na końcu
✔️ ściągawkę na dwie strony A4, plansze w PDF, gotowe .gitignore dla CubeIDE i CMake
✔️ instrukcję pracy z gitem dla agenta AI
✔️ fakturę VAT
Jak dostajesz kurs: zaraz po opłaceniu zamówienia dostęp trafia na adres e-mail z zamówienia. Jeśli masz już konto na platformie kursowej, kurs dopisze się do niego.
Kurs jest treścią cyfrową dostępną w całości od razu po zakupie. Dlatego składając zamówienie, zgadzasz się na natychmiastowy dostęp i rezygnujesz z prawa do odstąpienia od umowy w ciągu 14 dni — kurs nie podlega zwrotowi.